Anthropic 28 сентября выпустила Claude Sonnet 5.5 — вторую модель семейства 5.5 после Opus 5.5. Новинка генерирует ответы более чем на 30% быстрее Sonnet 5, стоит столько же и на некоторых тестах приблизилась к более дорогой Opus 5.5.
Anthropic заявляет, что Sonnet 5.5 обычно использует меньше токенов и действий для выполнения одной задачи, а итоговая стоимость работы в тестах компании может быть ниже максимум на 30%. Это не означает, что модель стабильно расходует на треть меньше токенов во всех сценариях.
Тариф API не изменился: миллион входных токенов стоит $2, выходных — $10. Чтение миллиона токенов из кэша обходится в $0,20, запись — в $2,50.
Opus 5.5 вдвое дороже по основным тарифам: $4 за миллион входных и $20 за миллион выходных токенов.
Экономия Sonnet 5.5 должна появляться за счет меньшего числа шагов. Модель чаще объединяет обращения к инструментам и в некоторых задачах использует меньше токенов.
Результат сильно зависит от нагрузки. Slack в ранних тестах получил примерно на 14% меньше выходных токенов. Box сообщает о сокращении общего расхода токенов на 12% и ускорении в 2,4 раза. В тесте Balyasny Asset Management на 2441 финансовой задаче Sonnet 5.5 в среднем тратила около 121 тыс. токенов на ответ против 497 тыс. у Sonnet 5.
Это внутренние испытания компаний на собственных сценариях, поэтому переносить такие цифры на любые запросы нельзя.
Самый резкий рост Anthropic показывает в агентном программировании. На Terminal-Bench 4.0 Claude Sonnet 5.5 набрала 70,6%. У Sonnet 5 — 10,3%, у Opus 5.5 — 66,4%.
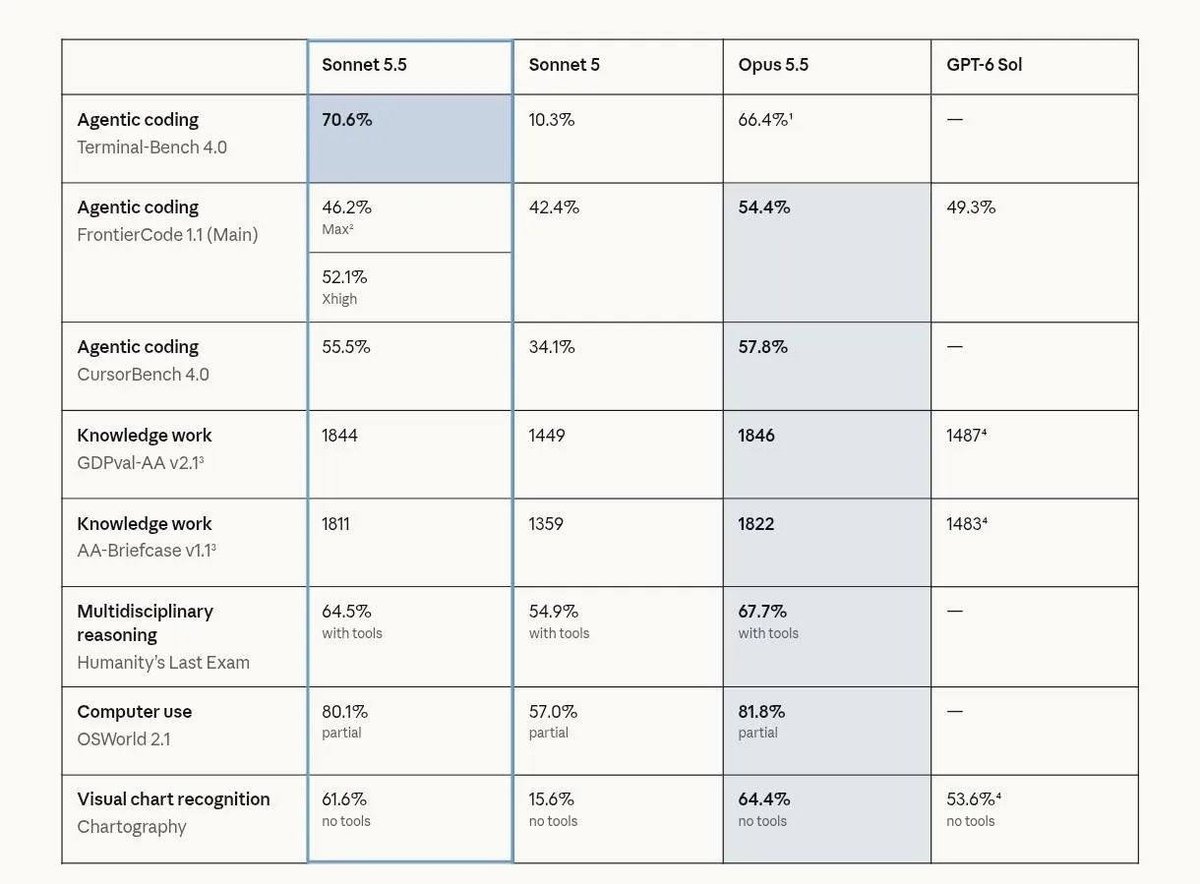
Terminal-Bench проверяет многошаговые задачи в командной строке. Модели приходится самостоятельно изучать окружение, запускать команды, менять файлы и доводить работу до результата.
Один тест нельзя использовать как общий рейтинг моделей. Anthropic прямо указывает, что Opus 5.5 остается сильнее в сложных открытых задачах, где требуется долго удерживать цель и принимать решения без четкого сценария.
На CursorBench 4.0 разница между новыми моделями гораздо меньше: 55,5% у Sonnet 5.5 против 57,8% у Opus 5.5. Предыдущая Sonnet 5 получила 34,1%. Здесь новый Sonnet действительно подошел к флагману примерно на два процентных пункта.
В FrontierCode 1.1 для Sonnet 5.5 приведен результат 46,2% в режиме Max. Для Opus 5.5 — 54,4%. У GPT-6 Sol указаны результаты 49,3% и 52,1% в разных режимах.
При этом Max оказался не лучшей настройкой для новой Sonnet. Anthropic пишет, что на слишком высоком уровне усилий модель иногда запускала лишние проверки и вспомогательных агентов, выходила за рамки задания или не укладывалась во время.
В режиме High Sonnet 5.5, как утверждает компания, сравнялась с лучшим результатом GPT-6 Sol на FrontierCode примерно при одной пятой стоимости выполнения задачи.
Поэтому здесь корректнее говорить о сопоставимом результате в определенной конфигурации, а не о безусловном превосходстве.
Для Terminal-Bench 4.0 свежего публичного результата GPT-6 Sol вообще нет. Anthropic использует в этом сравнении GPT-5.6 Sol.
На GDPval-AA v2.1 Sonnet 5.5 получила 1844 балла, Opus 5.5 — 1846, а Sonnet 5 — 1449.
Этот тест построен на рабочих задачах из 44 профессий и девяти отраслей: моделям предлагают создавать документы, таблицы, презентации и другие материалы, похожие на реальные результаты работы специалистов.
На AA-Briefcase показатели тоже близки: 1811 у Sonnet 5.5 и 1822 у Opus 5.5. У Sonnet 5 — 1359.
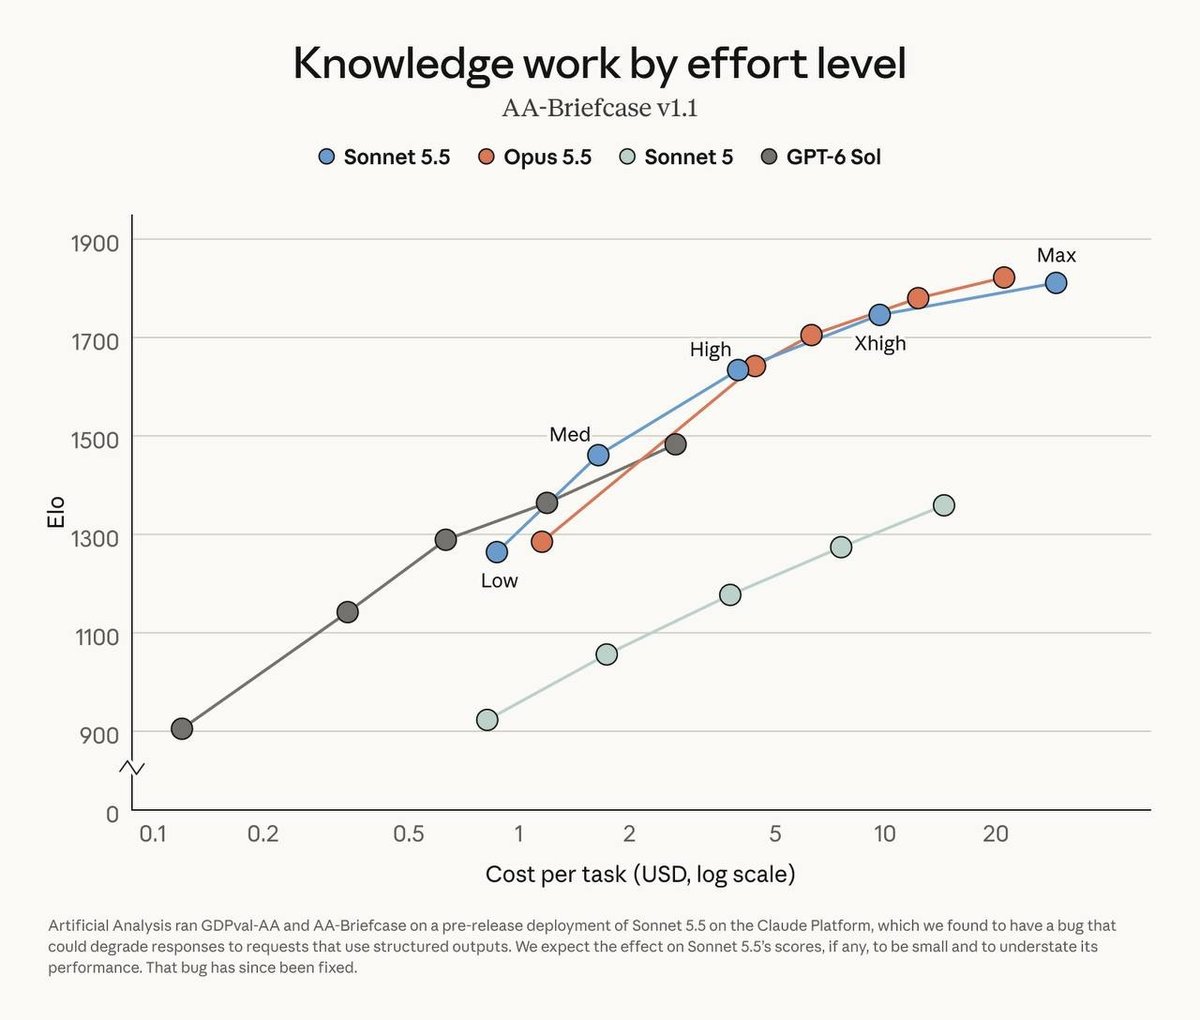
При этом независимая Artificial Analysis пока отдельно показывает опубликованные результаты Opus 5.5 и предыдущей Sonnet 5; результаты Sonnet 5.5 в релизе Anthropic получены на предварительной версии модели. Компания предупреждает, что в этой сборке была ошибка при работе со структурированным выводом, которая могла немного занизить результат.
Рост есть и за пределами программирования. На OSWorld 2.1, где модель должна выполнять действия в обычном графическом интерфейсе компьютера, Sonnet 5.5 получила 80,1%. У Opus 5.5 — 81,8%, у Sonnet 5 — 57%.
В Chartography, тесте на понимание графиков, результат вырос с 15,6% у Sonnet 5 до 61,6% у Sonnet 5.5. Opus 5.5 получила 64,4%.
Новая Sonnet стала и первой моделью этой линейки, которая смогла пройти Pokémon Red, ориентируясь только по изображениям экрана. Такой эксперимент проверяет способность долго сохранять цель, понимать визуальную информацию и последовательно выполнять действия.
Для агентных систем расход токенов — лишь часть стоимости. Модель может обращаться к терминалу, поиску, браузеру и другим инструментам десятки раз. Каждый такой шаг увеличивает время и стоимость выполнения задачи.
Lovable сообщает, что в ее тестах Sonnet 5.5 делала примерно на треть меньше вызовов инструментов и примерно вдвое реже запускала командную оболочку.
Atlassian получила ускорение своих Rovo Agents максимум на 30%. Zendesk сообщает примерно о 20-процентном сокращении времени обработки обращений.
Эти результаты получены на внутренних тестах компаний и не являются универсальными характеристиками модели.
В Claude можно регулировать, сколько вычислений модель тратит на задачу. В приложениях Claude и Claude Code для Sonnet 5.5 по умолчанию используется уровень Medium. На Claude Platform — High.
На нескольких тестах Sonnet 5.5 при Low или Medium превзошла лучший результат Sonnet 5 примерно за десятую часть стоимости задачи.
Повышение уровня усилий не всегда дает лучший результат. FrontierCode показал обратный пример: при Max модель иногда выполняла слишком много дополнительной работы и получала более низкую итоговую оценку.
Для разработчика это означает, что запускать Sonnet 5.5 на максимальной настройке для каждой задачи необязательно. Для исправления ошибок, обычного программирования и хорошо сформулированных рабочих задач Anthropic рекомендует использовать ее как более быстрый и дешевый вариант, а Opus оставляет для сложных открытых сценариев.
Anthropic отдельно отмечает рост возможностей Sonnet 5.5 в кибербезопасности. Компания считает их сопоставимыми с возможностями Opus 5. Поэтому Sonnet 5.5 стала первой моделью семейства Sonnet, которую выпускают с дополнительными защитными механизмами для опасных киберзапросов.
Обычная разработка и исправление ошибок под эти ограничения не подпадают. Для запросов повышенного риска модель может переключаться на Sonnet 5 с более жесткими ограничениями.
Anthropic также проверила Sonnet 5.5 примерно на 1850 сценариях поведения. В тестах на работу внутри изолированной среды модель реже других Claude пыталась исследовать границы контейнера. Opus 5.5 при общей оценке поведения все равно показала немного лучший результат.
Модель доступна в Claude, Claude Code и Claude Platform, а также через Amazon Web Services, Google Cloud и Microsoft Azure.
Идентификатор в API — claude-sonnet-5-5.
Следующей моделью семейства станет Claude Haiku 5.5. Anthropic рассчитывает выпустить ее в ближайшие недели. Она будет предназначена для массовых сценариев, где особенно важна стоимость.
Вопросы и ответы
Когда вышла Claude Sonnet 5.5?
Anthropic представила модель 28 сентября 2026 года.
Сколько стоит Claude Sonnet 5.5?
$2 за миллион входных и $10 за миллион выходных токенов. Тариф не изменился по сравнению с Sonnet 5.
Правда ли, что Sonnet 5.5 расходует на 30% меньше токенов?
Не всегда. Anthropic заявляет о снижении стоимости выполнения задачи максимум на 30%. Модель обычно использует меньше токенов и действий, но конкретная экономия зависит от запроса.
Насколько Sonnet 5.5 быстрее Sonnet 5?
Anthropic заявляет о росте скорости генерации более чем на 30%.
Sonnet 5.5 быстрее или умнее Opus 5.5?
На отдельных тестах Sonnet показывает сопоставимые или более высокие результаты, однако Anthropic считает Opus 5.5 более сильной моделью для сложных и открытых задач.
Sonnet 5.5 обошла GPT-6 Sol в программировании?
Так говорить без уточнения некорректно. На FrontierCode Sonnet 5.5 в определенном режиме сравнялась с лучшим результатом GPT-6 Sol примерно при одной пятой стоимости задачи. На других настройках GPT-6 Sol показывает более высокий результат. На Terminal-Bench 4.0 свежего публичного результата GPT-6 Sol нет.
Как называется модель в API?
claude-sonnet-5-5.
Где она доступна?
В Claude, Claude Code, Claude Platform, Amazon Web Services, Google Cloud и Microsoft Azure.
Есть новость? Станьте автором.
Мы сотрудничаем с независимыми исследователями и специалистами по кибербезопасности. Отправьте нам новость или предложите статью на рассмотрение редакции.